Arquitetura vantagens e limitações diante de llama cpp e vLLM
Pesquisa em 22 de outubro de 2026
O vllm.cpp procura reunir a distribuição de um motor nativo com mecanismos de atendimento concorrente inspirados no vLLM. Seu benefício mais claro é executar inferência sem um ambiente Python ou PyTorch dentro do motor. O projeto oferece recursos relevantes de escalonamento e cache, este texto é baseado no github oficial.
O que é o projeto e quem o mantém
Apresentado pela equipe do LocalAI e associado a Ettore Di Giacinto, o vllm.cpp é um motor de inferência desenvolvido em C++20. Ele carrega pesos já treinados e executa os cálculos necessários para produzir respostas. Pode funcionar como biblioteca incorporada a outra aplicação, ferramenta de terminal ou servidor HTTP. O repositório atual está em localai-org/vllm.cpp; endereços antigos sob mudler/vllm.cpp redirecionam para ele. [1]
O projeto é independente e não recebe endosso do vLLM oficial. A licença do código é Apache 2.0; os modelos mantêm suas próprias licenças. Seu objetivo inclui reproduzir comportamentos do vLLM, mas isso não equivale a compatibilidade completa com todas as suas versões, modelos, extensões ou configurações. [1, 4]
Como a arquitetura atende várias requisições
Em uma conversa com um modelo há duas etapas importantes. No prefill, o motor processa o texto de entrada. No decode, produz a continuação, normalmente um token por etapa. O escalonador decide quais requisições entram em cada rodada e como compartilhar a capacidade disponível. Separar essas etapas ajuda a entender por que um programa pode responder rapidamente a uma pessoa e ainda se comportar mal com muitas pessoas simultâneas.
O vllm.cpp implementa continuous batching, prefill em partes, preempção e reutilização de prefixos. Com continuous batching, novas requisições podem entrar à medida que outras terminam, sem esperar o lote inteiro acabar. Por exemplo, uma resposta curta pode liberar espaço para uma nova conversa enquanto outra resposta longa continua. O benefício depende da carga e dos kernels que realmente executam o modelo. [4]
O KV cache paginado armazena os estados de atenção em blocos administrados pelo motor. A técnica reduz desperdícios de alocação e permite compartilhar blocos quando há prefixos compatíveis. Ela atua sobre a memória usada pelo contexto; não comprime automaticamente os pesos do modelo. O trabalho original sobre PagedAttention explica essa relação entre fragmentação, compartilhamento e capacidade de agrupar requisições. [5]
O projeto também expõe políticas inspiradas no SGLang. A opção chamada RadixAttention é um alias para o cache automático de prefixos por hash do próprio motor; a documentação esclarece que não existe um caminho separado com uma árvore radix. A política LPM prioriza requisições com o maior prefixo já disponível no cache e depende desse cache estar habilitado. Essa escolha pode evitar trabalho repetido em aplicações com um prompt de sistema compartilhado. [6]
Biblioteca formatos e compatibilidade
A interface C pública, em include/vllm.h, permite vinculação estática ou dinâmica e integração por FFI. Na consulta realizada, a ABI estava na versão 30, consultável por vllm_abi_version(). Isso facilita incorporar o motor a programas escritos em C, C++, Go ou Rust. A ABI tem regras explícitas de evolução; internamente, os comandos e o servidor continuam mudando rapidamente. [2]
O servidor oferece /v1/chat/completions, /v1/completions, streaming, /metrics e tokenização. Endpoints para embeddings e áudio dependem da arquitetura e dos callbacks carregados. A API compatível com OpenAI facilita reutilizar clientes, mas seus recursos precisam ser confirmados. Até /health indica apenas que o processo está vivo, sem comprovar uma primeira geração concluída. [7]
Os formatos centrais são Safetensors e GGUF, com caminhos para NVFP4, FP8 e famílias GGUF. A compatibilidade depende da arquitetura, do layout dos tensores, da quantização e do backend. Aceitar um formato em uma família não garante que qualquer checkpoint com esse rótulo execute em outra. A documentação, por exemplo, ainda recusa GGUF TQ1_0 e TQ2_0, apesar da existência de kernels ternários. [8]
A decodificação especulativa inclui MTP, DFlash e caminhos com n-gramas, com diferentes níveis de validação. O documento também distingue métodos aceitos no JSON de métodos que realmente executam: draft_model tem configuração reconhecida, mas a carga é recusada por faltar o caminho de execução. Ganhos dependem do modelo, da taxa de aceitação e da carga; a existência de uma opção não demonstra aceleração em qualquer cenário. [9]
Hardware e distribuição
O motor textual usa seu próprio runtime de tensores. A compilação utiliza CMake e um compilador C++20; o servidor usa cpp-httplib. Há backends CPU, CUDA, Metal e Vulkan, com cobertura que varia por operação e modelo. No caminho CUDA, alguns kernels Triton já são distribuídos como código previamente compilado: Python e Triton são necessários para regenerá-los, não para executar esses binários. Os drivers e as dependências do backend continuam necessários. [10]
| Ambiente | Situação documentada e consequência |
| CPU x86 e Arm | Há caminhos nativos e seleção de instruções. Velocidade deve ser medida no processador e no modelo escolhidos. |
| NVIDIA CUDA | A referência principal de medição é o GB10. Compilar para outra arquitetura CUDA não comprova o mesmo desempenho. |
| Apple Metal e Vulkan | Há implementações, mas a cobertura e a validação variam entre operações e modelos. |
| AMD ROCm | Há execuções nativas em caminhos específicos; permanecem lacunas de correção e de validação entre dispositivos. |
| Intel XPU e NPU | Não há base documental para prometer aceleração Intel NPU pronta. A matriz ainda indica lacunas nos backends XPU. |
Fontes da matriz: guias de compilação e ROCm e matriz de funcionalidades. Suporte por Vulkan a uma GPU não implica suporte à NPU do mesmo fabricante. [4, 10, 11]
A release publicada mais recente encontrada foi a v0.0.2, de 11 de agosto de 2026. Seus arquivos para Linux e macOS possuem classificações distintas, incluindo stable e preview. Recursos descritos na branch principal em outubro podem não estar nesse pacote de agosto. Os arquivos também têm exigências de ABI do sistema e arquitetura do dispositivo; um executável pequeno não é automaticamente portátil para qualquer distribuição Linux ou GPU. [12, 13]
O que os números publicados demonstram
Os resultados abaixo foram publicados pelos mantenedores e constituem evidência documental, sem execução de novos benchmarks nesta análise. A principal ressalva está no próprio protocolo: várias comparações foram feitas contra uma referência anterior do vLLM e aguardam repetição após a mudança da referência em setembro. As séries identificadas como vLLM 0.25.0 são marcadas como superadas. Portanto, resultados históricos não comprovam paridade com a versão atual. [3]
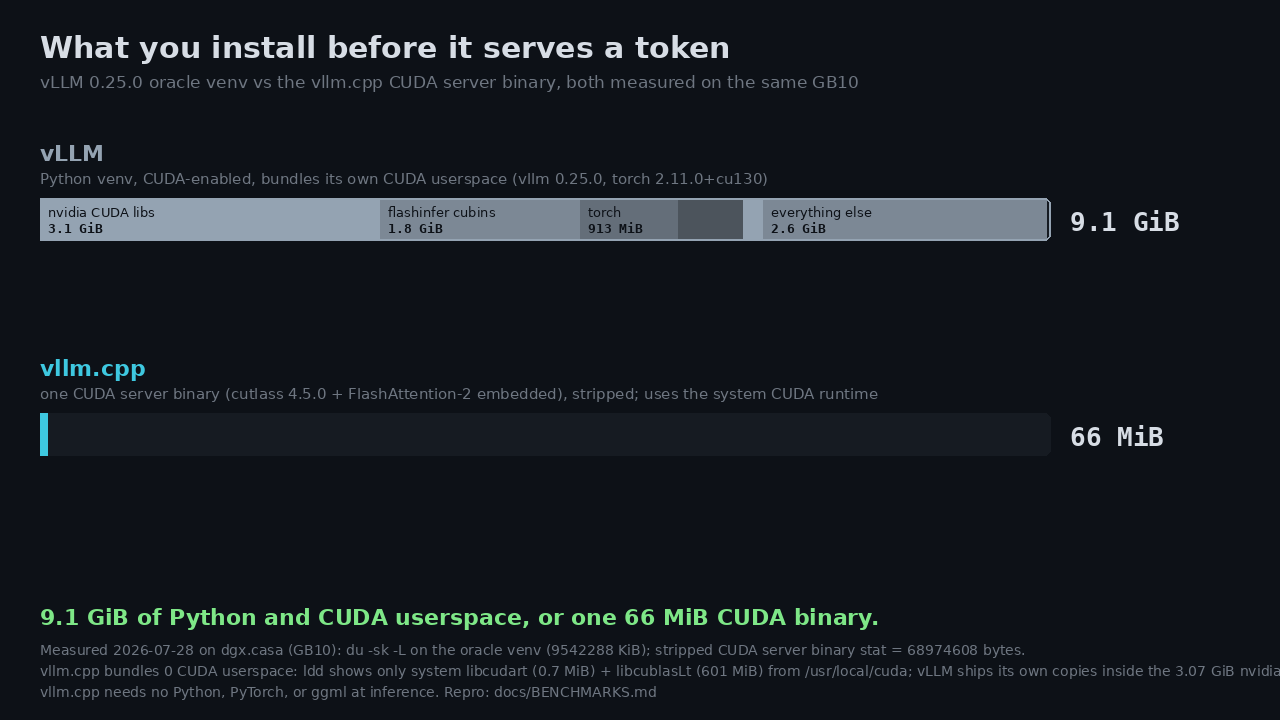
O anúncio de aproximadamente 140 vezes menos para instalar compara um binário de 66 MiB com uma instalação de 9,1 GiB, medidos no ambiente usado pelo projeto. A ordem de grandeza é relevante para distribuição, mas não representa uma redução de 140 vezes na RAM, na VRAM ou na memória necessária aos pesos. Contêineres, modelos e drivers também não cabem automaticamente nesses 66 MiB. [1, 13]
| Métrica publicada | vllm.cpp | vLLM | Como interpretar |
| Pico de PSS | 24,88 GiB | 28,18 GiB | Aproximadamente 11,7% menos no ensaio. |
| Pico de RSS | 24,88 GiB | 28,56 GiB | Outra medida de memória residente; não somar à PSS. |
| Queda de MemAvailable | 68,35 GiB | 80,66 GiB | Variação da memória disponível do sistema naquele ensaio. |
A tabela de memória refere-se ao Qwen3.6-27B NVFP4 no GB10, durante a janela de atendimento. O GB10 usa memória unificada: números de memória do processo e do dispositivo não devem ser somados como se fossem RAM e VRAM fisicamente independentes. Os valores demonstram uma economia naquele teste, sem estabelecer uma porcentagem universal. [3, 14]
O relatório detalhado de atendimento também preserva um contraexemplo: para outro checkpoint/caminho do Qwen3.6-27B, registra pico de RSS de 21,10 GiB no vllm.cpp e 13,09 GiB no vLLM. São medições históricas de configurações distintas da tabela anterior. Elas mostram por que a retirada do Python, isoladamente, não garante menor uso de memória em todos os modelos. [15]
Na série histórica do Qwen3.6-27B NVFP4 da Unsloth, o projeto publicou 86,05 contra 82,32 tokens totais por segundo com uma requisição, e tratou as demais concorrências como empates. Esses tokens totais incluem entrada e saída; não são 86 tokens gerados por segundo. O relatório específico também contém resultados abaixo do vLLM para outros checkpoints e cargas. Como as referências mudaram, a leitura correta é que houve cenários competitivos, sem evidência de vitória geral ou atual. [3, 15]
A comparação com llama.cpp exige ainda mais cautela. O relatório de CPU informa que um denominador usado era um fork local com alterações de desempenho e pede nova medição contra o upstream fixado. Há também séries antigas em que vllm.cpp perde. A página diz expressamente que não mediu atendimento concorrente contra o servidor llama.cpp naquele ensaio. Assim, não há fundamento para transformar a antiga alegação de ganho no prefill em superioridade geral. [16]
Um levantamento exploratório em AMD Strix Halo torna a limitação mais concreta: com Qwen3.8-27B Q4_K_M, publicou 12,219 tok/s de decode para llama.cpp, 11,056 tok/s derivados para vLLM e 5,397 tok/s derivados para vllm.cpp. O próprio estudo não certifica a comparação: a verificação de tokens não passou, houve sessões distintas e parte das taxas foi inferida de tempos com dois comprimentos de saída. Ele documenta uma observação localizada desfavorável ao vllm.cpp, não um ranking reproduzido para todo hardware. [17]
Vantagens e desvantagens diante do vLLM
A principal vantagem é operacional. Distribuir e incorporar uma biblioteca nativa pode simplificar imagens de sistema, instaladores e aplicações que já são escritas em C ou C++. Também reduz a necessidade de manter um ambiente Python/PyTorch dentro do motor. Essa simplificação tem valor mesmo quando a taxa de geração empata. O ganho deve ser avaliado pelo pacote completo utilizado, inclusive bibliotecas e serviços externos. [2, 10, 13]
O carregamento direto de Safetensors e GGUF é outro atrativo para quem trabalha com os dois ecossistemas. É preciso, porém, corrigir uma comparação frequente: o vLLM também aceita GGUF. Sua documentação atual encaminha esse suporte ao vllm-gguf-plugin e o classifica como experimental e pouco otimizado. A diferença está na integração e na cobertura dos caminhos de execução, não na exclusividade do formato. [8, 18]
A desvantagem mais forte aparece na escala. O vllm.cpp descreve sua situação como single-GPU; o paralelismo de tensores possui trabalho e testes parciais, sem validação completa em duas GPUs na matriz consultada. Paralelismo de pipeline, de especialistas e execução multinó continuam incompletos. O vLLM documenta estratégias de tensor e pipeline parallelism para uma ou várias máquinas, o que o torna a escolha mais sustentada pela documentação para esses requisitos. [4, 19]
O vLLM também possui um ecossistema de implantação e uma arquitetura com servidor de API, núcleo do motor e workers. Essa organização traz componentes a operar, mas serve a necessidades de concorrência e distribuição. Descrever o vLLM apenas como Python lento seria incorreto: os cálculos pesados usam kernels especializados. A troca de linguagem da coordenação não determina, sozinha, a velocidade da GPU. O vLLM atual também documenta CPU, NVIDIA, AMD, Intel XPU e Apple Silicon, com diferentes mecanismos de suporte. [20, 21]
Vantagens e desvantagens diante do llama cpp
O atrativo do vllm.cpp é reunir Safetensors e uma arquitetura de atendimento inspirada no vLLM dentro de uma biblioteca nativa. Um serviço com muitas requisições e prefixos repetidos pode se beneficiar dessas escolhas, se o modelo e o backend necessários estiverem bem implementados. Isso é uma hipótese técnica para testar, e não uma vantagem de throughput já demonstrada contra llama.cpp em todas as situações. [2, 6, 16]
O llama.cpp já oferece execução nativa, quantizações, ampla variedade de backends e inferência híbrida CPU/GPU. Seu servidor documenta múltiplos usuários, continuous batching, cache, ferramentas, saídas estruturadas e decodificação especulativa. Portanto, a comparação não deve partir da ideia de que ele atende apenas uma pessoa ou carece de batching. O interesse está em comparar a eficiência e o comportamento dessas implementações na carga real. [22, 23]
Para máquinas pessoais, GGUF e combinações de CPU/GPU, a cobertura publicada do llama.cpp costuma oferecer um ponto de partida mais abrangente. O vllm.cpp precisa demonstrar um benefício concreto que compense a migração e as lacunas do caminho escolhido. Além disso, chamar a biblioteca nativa de diferencial exclusivo seria incorreto: ambos têm essa característica. As licenças do código são distintas, Apache 2.0 no vllm.cpp e MIT no llama.cpp. [1, 22, 24]
Limitações que influenciam a adoção
Algumas limitações ficam mais claras nos documentos específicos do que na apresentação do repositório. Elas devem orientar a escolha dos recursos:
Jump-forward. A opção existe e é validada, mas não tem chamador na execução de produção. Habilitá-la não acelera requisições no estado documentado. [6]
KV externo. O cliente C++ de LMCache possui caminho documentado de execução. O OffloadingConnector local para CPU/disco ainda não possui a parte que transfere os dados para as páginas do motor e, por isso, sua utilização é recusada. O servidor externo LMCache pode continuar exigindo seu próprio ambiente Python. [25]
Multimodalidade. No HTTP, o guia distingue Qwen3-VL e dots3-note, com testes de integração em CPU usando pesos sintéticos. Imagens exigem RGB bruto no caminho descrito; PNG, JPEG e entrada de vídeo são recusados. Registrar uma arquitetura multimodal não demonstra que todas as formas de entrada, interfaces ou aceleradores foram validados. [26]
Integrações incompletas. A matriz registra LoRA ainda sem uso completo pelo servidor. Recursos podem ter código, configuração ou testes locais sem uma execução completa acessível ao usuário. A evolução da branch principal também exige fixar uma versão ou commit e validar novamente após mudanças. [1, 4]
Como escolher e testar
| Necessidade | Ponto de partida sugerido |
| GGUF local e combinação de CPU e GPU | llama.cpp, pela cobertura publicada; confirmar o modelo e o backend. |
| Múltiplas GPUs ou máquinas | vLLM, pelos caminhos documentados de paralelismo e implantação. |
| Biblioteca C++ com atendimento no estilo vLLM | vllm.cpp como candidato a avaliação, fixando o commit e os recursos necessários. |
| Maior desempenho ou menor memória | Medir os três na mesma máquina e na mesma carga; o nome do projeto não decide. |
Essas sugestões são uma interpretação técnica da cobertura e dos limites descritos nas fontes, não resultados de um novo ensaio. Um teste útil mantém o mesmo checkpoint e quantização, template de conversa, modo de raciocínio, número de tokens de entrada e saída, dtype do KV cache e regras de parada. Deve testar separadamente cache frio, cache aquecido e concorrências representativas.
As métricas que permitem decidir são tempo até o primeiro token, tempo entre tokens, tokens de saída por segundo, latência completa, percentis p95/p99, falhas e consumo de memória do conjunto de processos. PSS, RSS, memória do dispositivo e memória disponível do sistema medem coisas diferentes. A utilização de CPU também precisa ser medida: a ausência de Python não comprova, por si só, menos trabalho de CPU, menor energia ou melhor throughput.
O vllm.cpp merece avaliação quando a distribuição nativa e a incorporação ao produto são prioridades. Uma adoção pode se justificar por manutenção e integração, mesmo com desempenho semelhante. Para substituir um serviço existente, o critério deve ser um resultado reproduzido no modelo, hardware e nível de concorrência da aplicação, com os recursos necessários funcionando de ponta a ponta.
Fontes primárias
Consulta em 22 de outubro de 2026. Os documentos do vllm.cpp abaixo apontam para o retrato consultado do repositório, commit 845b3c59d43d1da2583efa738b9ec9f715ba2312. As datas e referências dos benchmarks são as dos respectivos ensaios, que podem ser anteriores a esse commit. As páginas dos outros projetos refletem a documentação pública consultada na data da pesquisa.
[1] vllm.cpp — apresentação autoria licença e aviso de desenvolvimento
[2] vllm.cpp — interface C e versão da ABI
[3] vllm.cpp — protocolo referências superadas e medições pendentes
[4] vllm.cpp — funcionalidades cobertura e limitações
[5] Kwon e colaboradores — PagedAttention e gestão do KV cache
[6] vllm.cpp — políticas inspiradas no SGLang e jump-forward
[7] vllm.cpp — servidor rotas e comportamento das APIs
[8] vllm.cpp — uso formatos quantizados e tamanho do contexto
[9] vllm.cpp — métodos e limites da decodificação especulativa
[10] vllm.cpp — compilação dependências e backends
[11] vllm.cpp — guia e limites do backend ROCm
[12] vllm.cpp — releases e arquivos publicados
[13] vllm.cpp — distribuição binária e dependências externas
[14] vllm.cpp — medições de memória
[15] vllm.cpp — comparações de atendimento com vLLM
[16] vllm.cpp — comparação de CPU com llama.cpp e denominadores superados
[17] vllm.cpp — levantamento exploratório em AMD Strix Halo
[18] vLLM — documentação atual de GGUF e plugin
[19] vLLM — paralelismo e escala
[20] vLLM — arquitetura e processos
[21] vLLM — instalação e plataformas de hardware
[22] llama.cpp — apresentação e backends
[23] llama.cpp — recursos e opções do servidor
[24] llama.cpp — licença MIT
[25] vllm.cpp — conectores de KV e limitações
[26] vllm.cpp — entradas multimodais no servidor HTTP

